La IA no nos va a matar; sus dueños, puede que sí
Análisis de la situación técnica de la Inteligencia Artificial, los usos que proyectan los estados y de qué sería capaz bajo relaciones sociales y de producción socialistas.
La expresión Inteligencia Artificial nació como una etiqueta acuñada por John McCarthy en 1955 para pedir financiación para el seminario de Dartmouth, y reconoció más tarde que la eligió en parte para distanciarse de la cibernética y hacerla parecer más disruptiva. Desde entonces el término ha funcionado a la vez como programa de investigación y como reclamo para atraer fondos públicos, militares y privados. Ya en 1958 la prensa anunció el perceptrón (clasificador simple), la primera red neuronal capaz de aprender a partir de ejemplos, como el embrión de una máquina que pronto andaría, hablaría y tendría conciencia de sí misma, y la historia de la disciplina ha sido desde entonces una alternancia de promesas desmesuradas y periodos de desfinanciación, los llamados “inviernos de la IA”.
1. Lo que la máquina puede y no puede hacer hoy en día
Lo que hoy se denomina inteligencia artificial no es una máquina única, sino un conjunto heterogéneo de técnicas estadísticas que llevan décadas incrustándose en la producción, el comercio y la administración, y de las que los grandes modelos de lenguaje son solo la cara más visible. Su difusión empresarial es rápida pero desigual: según Eurostat, en 2025 utilizaba alguna tecnología de IA el 20% de las empresas europeas con diez o más empleados, frente a en torno al 8% en 2023, con un 62,5% en el sector de información y comunicaciones. El uso más extendido era el análisis de texto escrito (11,8%), señal de que la ola generativa se ha sumado a una base anterior de usos predictivos y de visión más que sustituirla.
Esas técnicas pueden agruparse en familias ya consolidadas (el aprendizaje automático predictivo, los sistemas de recomendación, la optimización, la visión por computador y el reconocimiento del habla) y en otras más recientes, desarrolladas sobre todo desde 2022 (los modelos de lenguaje y de razonamiento, los generativos de imagen, audio y vídeo, los agentes, la robótica y la IA científica especializada), que se recorren en los apartados siguientes.
La cronología de los hitos superados permite leer esa heterogeneidad en el tiempo, y conviene atender a la forma de los problemas vencidos, porque casi todos comparten rasgos que no se dan en la vida social.
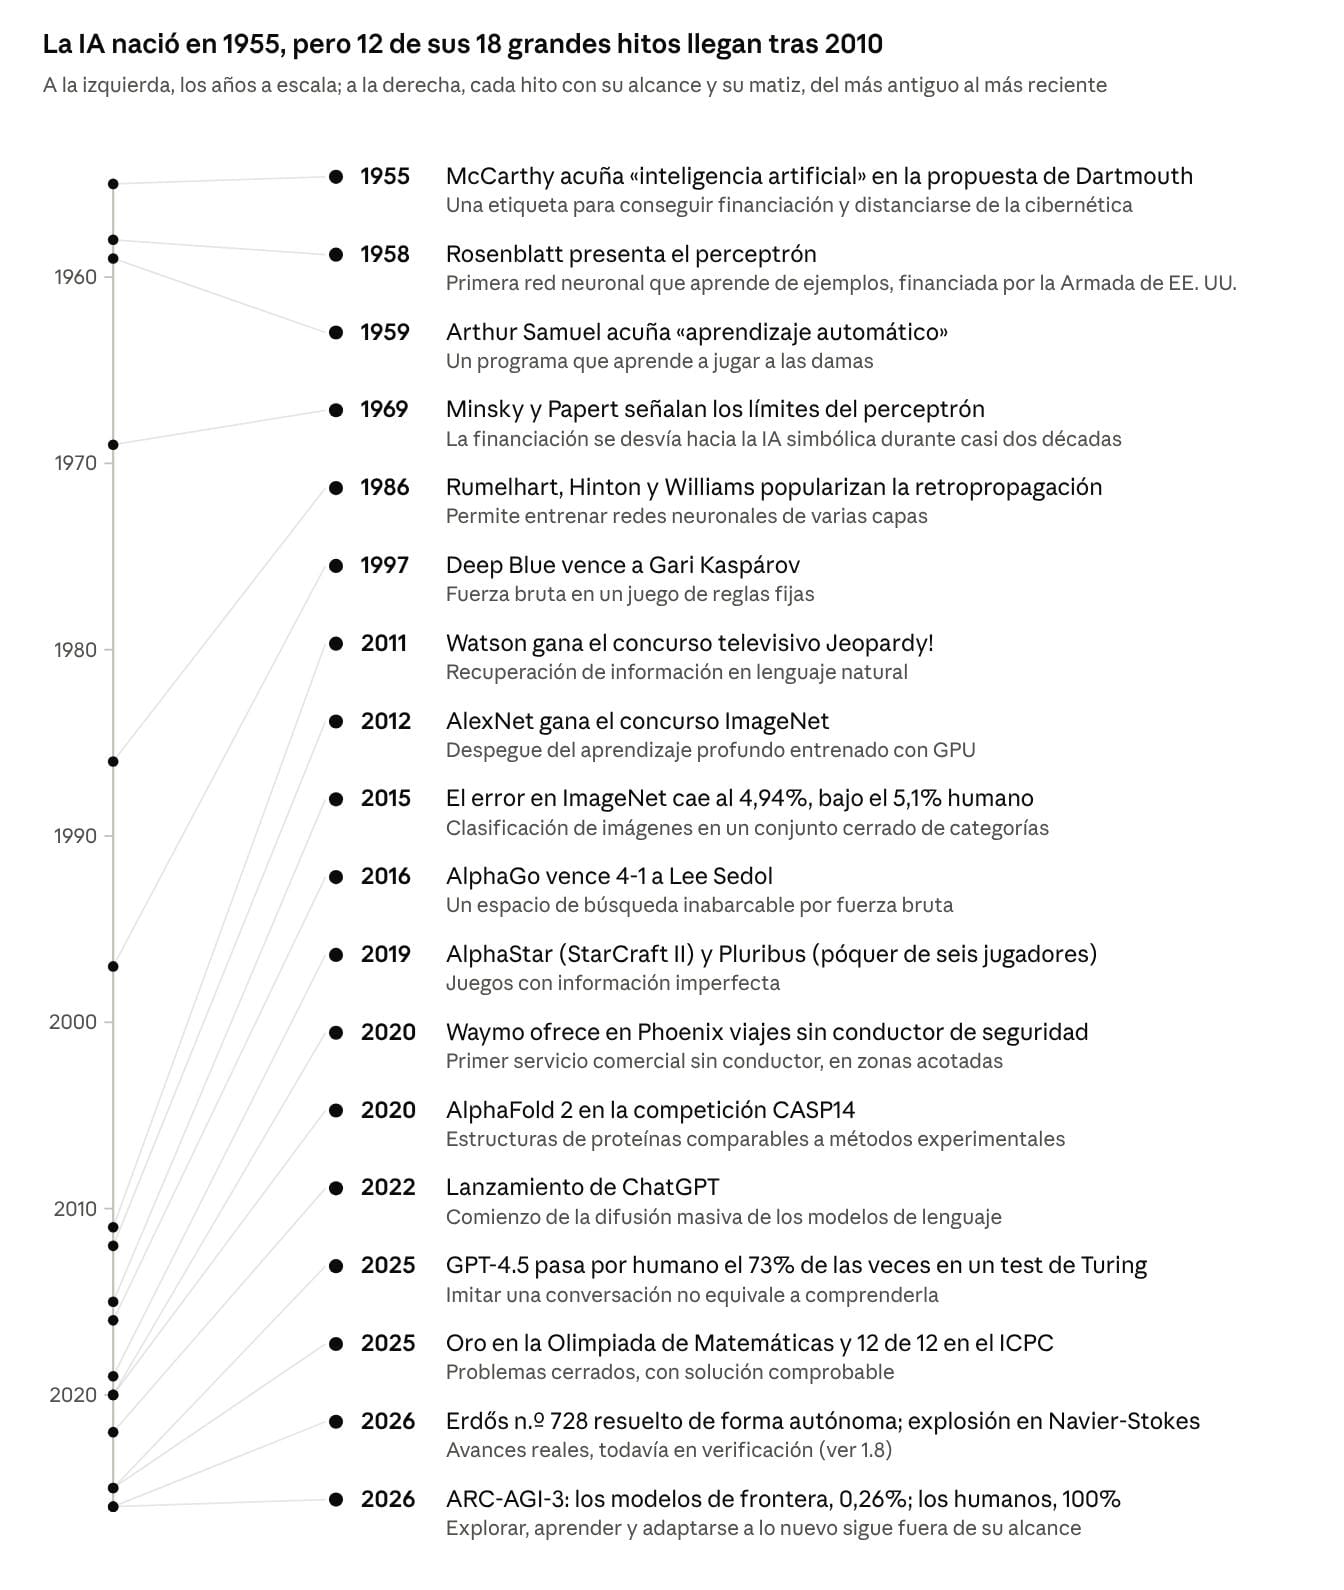
Aunque sea discutible, se observa que, gracias a la enorme potencia de cómputo que hay detrás, la IA puede superar a los humanos allí donde la tarea está cerrada, las reglas son fijas, la respuesta puede comprobarse automáticamente y abundan los datos o las simulaciones para entrenar, como en el ajedrez, el Go o la clasificación de imágenes, pero tropieza en cuanto el entorno es abierto, cambiante o carece de objetivo explícito. Las pruebas de razonamiento abstracto ARC lo ilustran: los modelos obtenían menos de un 5% en ARC-AGI-2 en mayo de 2025 y un 77,1% un año después, pero cuando en marzo de 2026 se presentó su versión interactiva, que obliga a descubrir las reglas y el objetivo sin instrucciones, el rendimiento cayó por debajo del 1%. Una parte creciente de estos hitos la eligen y anuncian, además, las propias empresas, para las que cada récord es también un argumento ante los inversores.
1.1. Qué es técnicamente la IA actual
La IA simbólica, dominante entre 1960 y 1980, codificaba el conocimiento en reglas explícitas escritas por expertos; la IA dominante hoy procede a la inversa y ajusta millones o billones de parámetros numéricos (valores ajustables) hasta que sus predicciones se acercan a los ejemplos de entrenamiento. En este aprendizaje automático conviven técnicas clásicas, como los árboles de decisión o la regresión, que siguen dominando el análisis de datos tabulares en bancos y aseguradoras, y el aprendizaje profundo (capas múltiples), basado en redes neuronales de muchas capas que extraen por sí mismas los rasgos relevantes de imágenes, sonidos o textos.
Ambas corrientes nacieron casi a la vez. El perceptrón ya aprendía ajustando pesos, pero una crítica de 1969 sobre los límites de las redes de una sola capa desvió la financiación hacia los sistemas simbólicos durante cerca de dos décadas, hasta que en 1986 la retropropagación (ajuste hacia atrás) permitió entrenar redes de varias capas. Lo que cambió hacia 2012 no fue la idea, sino su base material: las enormes bases de datos de las plataformas digitales y los chips o procesadores gráficos (GPU) diseñados para los videojuegos permitieron entrenar redes mucho más profundas. El salto reciente depende, así, menos de un descubrimiento intelectual que de la disponibilidad de capital, datos y cómputo concentrados en muy pocas manos.
El punto de inflexión fue la arquitectura de atención transformer (Google, 2017), cuyo mecanismo de atención pondera a la vez la relación entre todos los fragmentos de una secuencia y permite entrenar en paralelo sobre cantidades de datos antes inabordables. Sobre ella se construyen los grandes modelos de lenguaje (LLM, por sus siglas en inglés), que descomponen el texto en tokens (fragmentos de texto) y aprenden a predecir el siguiente a partir del contexto, y que, a escala suficiente, programan, traducen o razonan de una manera que podría describirse como autónoma.
Su ciclo de vida tiene tres fases: el preentrenamiento (aprende patrones), que expone el modelo a billones de tokens para que absorba regularidades estadísticas generales; el posentrenamiento (ajuste supervisado), que lo ajusta con ejemplos supervisados y aprendizaje por refuerzo, y donde se le inculcan el tono, las negativas y las preferencias de comportamiento que decide la empresa; y la inferencia, el uso cotidiano, en el que cada respuesta consume cómputo. Los modelos de razonamiento, generalizados desde 2024, trasladan parte del esfuerzo a esta última fase al generar largas cadenas de pasos intermedios, y la mezcla de expertos (una arquitectura de IA que combina varios modelos o redes neuronales especializadas y activa los más adecuados según la tarea) abarata ese coste activando solo una fracción del modelo en cada paso.
En términos estrictos, un modelo de lenguaje es una distribución de probabilidad condicionada (probabilidades de salida) que asigna a cada posible continuación de un texto una probabilidad aprendida, y su respuesta es una muestra de esa distribución; por eso la misma pregunta puede producir respuestas distintas y un argumento impecable en apariencia puede contener un error. No tiene objetivos propios más allá de los que le fija su entrenamiento, y su «moral» (a qué se niega, qué recomienda o cómo trata ciertos temas) es un conjunto de conductas inducidas en el posentrenamiento según criterios que decide su propietario. Esa naturaleza estadística explica tanto su potencia como sus fallos, y obliga, en la ciencia y las matemáticas, a verificar cada resultado.
1.2. La capacidad se compra
El progreso de la última década descansa menos en ideas nuevas que en las llamadas leyes de escalado (a más escala, más rendimiento), según las cuales el rendimiento de un modelo mejora de forma predecible al aumentar a la vez sus parámetros, sus datos y su cómputo. Epoch AI, el centro de referencia en estas mediciones, estima que el cómputo de entrenamiento de los modelos de lenguaje de frontera crece unas 5 veces al año desde 2020, es decir, se duplica cada cinco meses, mientras que el rendimiento de los chips por dólar mejora solo un 37% anual; aunque la eficiencia algorítmica se triplica cada año, la distancia entre ambas curvas solo se cubre con más chips, más centros de datos y más energía.
El coste en hardware y energía de la ejecución final de entrenamiento de los modelos de frontera se ha multiplicado por 2,4 cada año desde 2016 y, de seguir así, superará los mil millones de dólares en 2027, lo que deja la frontera fuera del alcance de todas las organizaciones salvo las mejor financiadas; y esa ejecución es solo una parte minoritaria del gasto, dominado por los experimentos previos. La inferencia, en cambio, se abarata unas cien veces al año para un nivel de rendimiento dado, aunque el uso masivo y los modelos de razonamiento hacen que la factura total no deje de crecer.
Los otros insumos también tienen límites físicos. El texto público de «calidad» escrito por humanos, unos 300 billones de tokens, podría agotarse como fuente de entrenamiento entre 2026 y 2032 (apartado 2.3), y la Agencia Internacional de la Energía (AIE) cifra el consumo de los centros de datos en unos 415 TWh (teravatios hora) en 2024, alrededor del 1,5% de la electricidad mundial, y prevé unos 945 TWh en 2030, algo más que el consumo actual de Japón. A ello se suma una cadena de suministro extremadamente concentrada (apartado 2.4).
Si la capacidad de un modelo depende sobre todo del cómputo, y el cómputo exigido crece mucho más deprisa de lo que se abarata, la frontera de la IA queda reservada a quien puede movilizar capital a una escala que solo alcanzan unas pocas corporaciones monopolistas y Estados, algo que ya hoy se verifica empíricamente.
1.3. La IA antes de ChatGPT
Antes de los asistentes conversacionales, el aprendizaje automático ya decidía a quién se concedía un crédito, qué transacción se bloqueaba por sospecha de fraude, cuánto costaba un seguro, cuánto debía pedir un supermercado o qué máquina estaba a punto de averiarse. Estos modelos clasifican, ordenan y estiman probabilidades a partir de datos históricos, y constituyen la capa más extendida, más rentable y menos visible de la IA, porque operan sin que los afectados sepan que un algoritmo ha intervenido en la decisión.
Los sistemas de recomendación son su expresión más influyente en la vida cotidiana: según los responsables de Netflix, el suyo influía ya en 2015 en la elección de en torno al 80% de las horas vistas, y le atribuían un valor de unos mil millones de dólares anuales en bajas evitadas. La misma lógica sostiene la publicidad segmentada de buscadores, redes sociales y comercio electrónico, y lo que maximiza, la atención o la probabilidad de compra, es un objetivo que fija su propietario y no una propiedad de la técnica. Lo mismo vale para la optimización de sistemas físicos, que puede ahorrar energía (apartado 3.2), planificar rutas o programar turnos de trabajo: su efecto social depende por completo de lo que se decida optimizar.
La administración pública ofrece ejemplos ligados al control de comportamientos o a la «detección automática de delitos», que sientan las bases de los nuevos mecanismos de control. En Países Bajos, la agencia tributaria usó desde 2013 un modelo de riesgo con elementos de autoaprendizaje para detectar fraude en las ayudas al cuidado infantil, y Amnistía Internacional documentó que la variable «nacionalidad neerlandesa, sí o no» elevaba la puntuación de los extranjeros, un caso de perfilado racial que contribuyó a la dimisión del Gobierno en enero de 2021. En Australia, Robodebt, que entre 2015 y 2019 cruzaba datos fiscales y de prestaciones, generó deudas indebidas por 1.700 millones de dólares australianos contra unas 433.000 personas, y ni siquiera empleaba aprendizaje automático: el daño no depende de la sofisticación del algoritmo, sino de la decisión política de automatizar la sospecha sobre los más pobres.
Sus límites están bien documentados, aunque su éxito se mida en cuentas de resultados y no en concursos. Un modelo entrenado con datos históricos reproduce las desigualdades que contienen y puede amplificarlas mediante bucles de retroalimentación, y pierde fiabilidad cuando el mundo deja de parecerse al pasado del que aprendió (la llamada deriva de los datos), problemas a los que las IA actuales son igual de susceptibles, o más.
1.4. Lenguaje y razonamiento
En julio de 2025 utilizaba ChatGPT en torno al 10% de la población adulta mundial, según un estudio del NBER, y el AI Index 2026 cifra en un 53% la adopción de la IA generativa en los países estudiados apenas tres años después de su lanzamiento, una de las expansiones más bruscas de cualquier tecnología. No es, sin embargo, una herramienta esencialmente laboral: los mensajes ajenos al trabajo pasaron del 53% a más del 70% entre 2024 y 2025, y casi el 80% de las conversaciones son orientación práctica, búsqueda de información o redacción. En el trabajo domina la escritura (en torno al 40% de los mensajes laborales), y los sectores de mayor penetración son la atención al cliente, la traducción, los servicios jurídicos y profesionales, la educación y el desarrollo de software.
Este nivel es el que más titulares ha generado. GPT-4.5 fue tomado por humano el 73% de las veces en un test de Turing (prueba de humanidad), más a menudo que los propios participantes humanos, aunque solo cuando se le instruía para adoptar un personaje; en 2025 los modelos de Google DeepMind y OpenAI alcanzaron nivel de oro en la Olimpiada Internacional de Matemáticas, y en la final mundial del concurso universitario de programación ICPC el sistema de OpenAI resolvió los 12 problemas, uno más que el mejor equipo. El AI Index constata además que la brecha entre los modelos estadounidenses y chinos se ha cerrado en la práctica (apartado 2.7).
Las cifras de lanzamiento, no obstante, pueden inflarse. OpenAI presentó en 2023 un GPT-4 en torno al percentil 90 del examen de abogacía estadounidense, pero un estudio del MIT (2024) mostró que la comparación se hacía con una convocatoria sesgada hacia repetidores: frente a quienes aprobaban, el modelo caía al percentil 48 en conjunto y al 15 en redacción, la sección más parecida al trabajo real de un abogado. A ello se suma la contaminación de los bancos de prueba, cuyas preguntas acaban en los datos de entrenamiento.
Algunos límites son estructurales. Un trabajo de investigadores de OpenAI de 2025, «Why Language Models Hallucinate», sostiene que las alucinaciones, falsedades enunciadas con apariencia de verdad, son consecuencia de un entrenamiento y una evaluación que premian arriesgar una respuesta antes que reconocer la incertidumbre, como el estudiante que adivina en un examen tipo test. La fragilidad aparece también en tareas triviales: el AI Index resume la paradoja de una IA que gana una olimpiada matemática pero no sabe leer la hora en un reloj analógico. Estos sistemas dominan la producción de lenguaje plausible, que coincide con la verdad allí donde la respuesta puede comprobarse o ya ha sido enunciada, pero se separa de ella en cuanto la verificación depende del mundo exterior.
1.5. Agentes y automatización de tareas
Los agentes de IA son ya uno de los niveles al alcance del público general: modelos de lenguaje conectados con herramientas externas (un navegador, una terminal, el correo o una base de datos) a los que se encarga completar de forma relativamente autónoma tareas de varios pasos, sobre todo en el desarrollo de software y en las tareas administrativas internas de las empresas. Los datos de Anthropic muestran cómo se difumina el criterio humano a medida que la máquina gana autonomía: en su chat de consumo, las interacciones de colaboración seguían siendo en noviembre de 2025 algo más frecuentes que las de delegación (52% frente a 45%), mientras que en el uso empresarial agéntico en torno a tres cuartas partes del tráfico eran tareas automatizadas, muy concentradas en la programación.
Sus hitos se miden en duración y autonomía. En SWE-bench Verified, una batería de errores reales de software que el modelo debe corregir sin ayuda, el rendimiento pasó en un año del 60% a casi el 100% del nivel humano. Más revelador es el «horizonte temporal» de METR, un laboratorio independiente de evaluación: la duración, en tiempo de un profesional humano, de las tareas que el modelo completa con éxito la mitad de las veces. Con su metodología revisada de enero de 2026, ese horizonte se duplica cada 131 días desde 2023 y cada 89 días desde 2024, y en marzo de 2026 METR atribuyó a una versión preliminar de Claude Mythos al menos 16 horas, con un margen de incertidumbre muy amplio (entre 8,5 y 55).
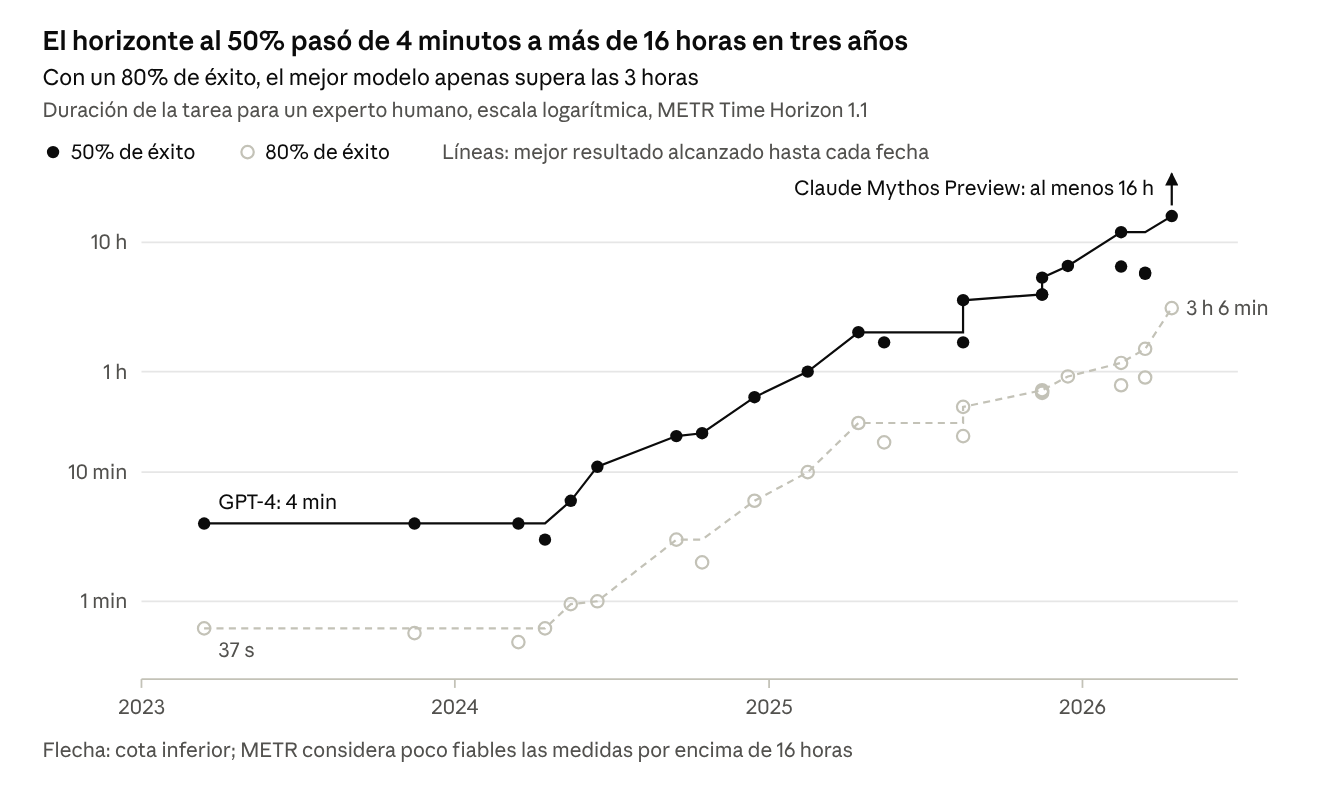
La fiabilidad, sin embargo, crece mucho más despacio. Con un 80% de éxito, más cercano a un uso productivo, el horizonte de ese modelo rondaba las tres horas, y un sistema que requiere menos intervenciones puede fallar de formas más difíciles de detectar. Los errores encadenados explican el problema: un agente que acierta el 95% de las veces en cada paso solo completa bien seis de cada diez tareas de diez pasos. En un ensayo controlado de METR de julio de 2025, desarrolladores experimentados trabajando en sus propios proyectos fueron un 19% más lentos con asistencia de IA, aunque creían haber ganado velocidad, y la consultora Gartner prevé que más del 40% de los proyectos de IA agéntica se cancelen antes de finales de 2027.
De aquí se desprende la dimensión técnica del mito de que la IA «nos va a quitar el trabajo». Lo que se automatiza son fragmentos de tareas digitales, repetitivas y comprobables, no ocupaciones enteras, que combinan tareas heterogéneas, trato con personas y responsabilidad sobre el resultado. El índice de la Organización Internacional del Trabajo (OIT) de 2025 estima que uno de cada cuatro empleos del mundo tiene algún grado de exposición a la IA generativa, pero solo el 3,3% está en el nivel más alto, y concluye que la transformación de los puestos es más probable que su desaparición. Que esa capacidad se traduzca en despidos, intensificación del trabajo o reducción de la jornada no lo decide la técnica, sino quien controla su implantación según la lógica de la rentabilidad, y la fuerza de trabajo humana es, en la mayoría de casos, más barata, eficiente y fiable que su sustitución por un agente.
Por último, los modelos de difusión (generan imágenes) generan hoy vídeos y voces difícilmente distinguibles de los reales, lo que ha abaratado la producción audiovisual y multiplicado las falsificaciones y la desinformación. Lejos de dotar a la máquina de una creatividad similar a la humana, aprenden a simularla apoyándose en la apropiación masiva de obras protegidas, origen de una oleada de litigios, y comparten el límite de los modelos de lenguaje: generan lo verosímil sin garantía de que sea verdadero, con un entrenamiento futuro constreñido por la escasez de obras con las que entrenar.
1.6. Percepción, generación y mundo físico
La visión por computador fue la primera rama del aprendizaje profundo en alcanzar madurez industrial. La agencia estadounidense del medicamento (FDA) había autorizado hasta marzo de 2026 más de 1.500 dispositivos médicos con IA, en torno al 76% en radiología, donde la técnica funciona mejor por trabajar sobre imágenes estandarizadas y abundantes, aunque la evidencia clínica va por detrás de las autorizaciones, obtenidas en su mayoría por equivalencia con productos previos. El reconocimiento facial, por su parte, presentaba en muchos algoritmos, según el instituto estadounidense de normalización (NIST, 2019), tasas de falsos positivos entre diez y cien veces mayores para algunos grupos demográficos, un sesgo con consecuencias directas en la vigilancia policial.
El salto al mundo físico es lento, más de lo que se proyectaba hace unos años. Un vehículo autónomo debe interpretar en tiempo real un entorno abierto, con peatones, obras, mal tiempo o situaciones ausentes de sus datos, donde un error no se corrige como en una pantalla y existen «decisiones morales» que obligan a priorizar el daño ajeno o el propio. Tras más de quince años de desarrollo, los servicios sin conductor solo funcionan en zonas cartografiadas con detalle, con apoyo remoto de operadores humanos y a un coste que limita su expansión. Dentro de esos márgenes, Waymo acumulaba en marzo de 2026 unos 220 millones de millas sin conductor y medio millón de viajes de pago semanales, con un 82% menos de accidentes con heridos que los conductores humanos según sus datos (un 81% según un estudio independiente), pero en un mundo acotado y preparado a su medida.
En la robótica industrial ocurre algo similar: en 2024 se instalaron 542.000 robots y el parque mundial alcanzó los 4,66 millones, con el 54% de las nuevas instalaciones en China, pero casi todos son brazos programados para repetir movimientos en entornos controlados, no sistemas que aprendan. La paradoja de Moravec explica la brecha: lo difícil para los humanos, como el cálculo o el ajedrez, es relativamente sencillo para una máquina, y lo que cualquier niño hace sin esfuerzo, como manipular un objeto desconocido o moverse por una casa desordenada, sigue siendo extraordinariamente difícil. Los humanoides de las demostraciones comerciales siguen en fase de prototipo o de pilotos acotados, en entornos ensayados hasta la saciedad.
Por último, los modelos de difusión generan hoy vídeos y voces difícilmente distinguibles de los reales, lo que ha abaratado la producción audiovisual y multiplicado las falsificaciones y la desinformación. Lejos de dotar a la máquina de una creatividad similar a la humana, aprenden a simularla apoyándose en la apropiación masiva de obras protegidas, origen de una oleada de litigios, y comparten el límite de los modelos de lenguaje: generan lo verosímil sin garantía de que sea verdadero, con un entrenamiento futuro constreñido por la escasez de obras con las que entrenar.
1.7. Ciencia y matemáticas
La ciencia es uno de los sectores donde la IA ha producido sus resultados más llamativos en los últimos meses. AlphaFold predijo la estructura de más de 200 millones de proteínas, las puso a disposición pública y valió a sus desarrolladores el Nobel de Química de 2024. GraphCast, de Google DeepMind, superó en Science (2023) al sistema de referencia del Centro Europeo de Previsiones Meteorológicas a Plazo Medio en el 90% de 1.380 objetivos de verificación, y el propio centro europeo puso en operación su modelo de IA en 2025. En farmacología, el rentosertib de Insilico Medicine, cuya diana y cuya molécula se identificaron con IA generativa, publicó en Nature Medicine en junio de 2025 resultados prometedores de fase IIa con 71 pacientes de fibrosis pulmonar, aunque los compuestos originados con IA superan la fase II en una proporción similar a la de los convencionales y ninguno ha completado aún la fase III. En materiales, en cambio, los 2,2 millones de cristales propuestos por GNoME en 2023 fueron puestos en duda por Anthony Cheetham y Ram Seshadri, que en 2024 encontraron escasas pruebas de compuestos a la vez nuevos, creíbles y útiles
En matemáticas, AlphaEvolve, un sistema de Google DeepMind, encontró en 2025 un procedimiento para multiplicar matrices complejas de 4×4 con 48 multiplicaciones, la primera mejora en ese caso sobre el algoritmo de Strassen de 1969, y en enero de 2026 el problema de Erdős n.º 728 se convirtió en el primero de esa colección resuelto de forma autónoma por una IA, con una prueba verificada mecánicamente en Lean, un asistente de demostraciones. Los anuncios de OpenAI, asociados a un incremento brutal de medios de computación a este tipo de tareas, en cambio, suponen un cambio cualitativo la forma en la que se dan este tipo de avances mediante la IA. En octubre de 2025 sus directivos afirmaron que GPT-5 había resuelto diez problemas de Erdős abiertos, y el responsable de esa colección, Thomas Bloom, lo calificó de tergiversación porque el modelo solo había localizado soluciones ya publicadas. En septiembre de 2026 la empresa afirmó haber demostrado mediante contraejemplo, una singularidad en tiempo finito de las ecuaciones de Navier-Stokes, para el caso tridimensional de fluidos incompresibles en presencia de una fuerza externa (una de las variantes del problema del milenio asociado a las mencionadas ecuaciones). Evidentemente un hito de esta magnitud exige un proceso exhaustivo de comprobación en el que a día de hoy un grupo de matemáticos ya ha señalado divergencias entre la prueba escrita y su versión en Lean (además de toda la polémica asociada al robo de datos y resultados de la comunidad científica).
Aun así, lo que realmente puede marcar el primer paso de un proceso en el que la producción científica (o el papel humano en esta) cambie su forma actual, se ve con la publicación de los 722 documentos el 6 de octubre de 2026. Ese día OpenAI publicó 722 manuscritos agrupados en 372 familias de resultados, todos ellos del área de las matemáticas, de los que solo 162 tenían formalizado su resultado principal. Lejos de ser un trabajo ordenado que ha seguido un proceso fiable y contrastable, estos resultados han sido fruto de un despliegue de capacidad computacional guiado por un modelo de IA interno y supervisado por un comité de matemáticos (todos parte de la empresa), los cuales han sido publicados sin seguir, en muchos de los casos, las convenciones para su correcta revisión por pares (control experto). Señal de esto mismo es la retirada de tres artículos en menos de 24 horas porque un error de signo invalidaba uno y arrastraba a los dos que dependían de él.
En este sentido, es conocido que el modo de producción capitalista desde sus orígenes ha orientado la ciencia hacia lo rentable o hacia un interés particular. El uso intensivo y cuasi-autónomo de la IA (junto con toda la infraestructura de cálculo que necesita para funcionar) supone, como se decía, un salto cualitativo, porque lo que pasa a manos privadas no es ya solo la financiación sino el propio instrumento de investigación: si en 2010 la industria desarrollaba solo el 11% de los mayores modelos de IA, en 2021 desarrollaba el 96%, es decir, casi todos El AI Index 2025 añade que casi el 90% de los modelos destacados de 2024 procedió de la industria, frente al 60% del año anterior, aunque la universidad sigue liderando la investigación más citada y sigue siendo la encargada de la última revisión de los resultados producidos por la IA. En este sentido, volviendo a lo que suponen las nuevas prácticas de OpenAI con respecto a la resolución de problemas abiertos y de gran calado en las matemáticas, se conoce que los problemas los eligió directamente la empresa, el modelo que los resolvió no se ha publicado y tampoco las instrucciones ni el proceso de generación, y, sobre todo, no se han respetado los procesos indicados para la verificación. De esta manera, la comunidad científica se ve en la tesitura de que el rumbo de las investigaciones proviene de una máquina (o de un departamento de OpenAI, en el mejor de los casos) pero el coste de verificarlo recae sobre una comunidad académica mayoritariamente pública la cual se ve saturada por la escala en la que se presentan los resultados, cuyos artículos forman a su vez parte de los datos con que se entrenó el modelo.
Las demostraciones asistidas por ordenador no son nuevas. El teorema de los cuatro colores se demostró en 1976 mediante una comprobación de casos que ningún humano podía revisar entera, y la conjetura de Kepler, demostrada en 1998, solo se dio por cerrada en 2014, cuando fue verificada formalmente . Lo nuevo en el caso de los grandes modelos de lenguaje que se emplean hoy en día es que el generador actúa en esencia con un núcleo estadístico y la producción es masiva, y ello choca con una idea de la demostración que no es solo un certificado de verdad sino también una forma de comprensión humana.
De ahí surgen varias contradicciones. Un generador probabilístico produce resultados que solo adquieren validez deductiva tras una comprobación externaEn este caso, la velocidad de producción desborda la de validación, hasta el punto de que referentes de la comunidad matemática advierten de una «indigestión de pruebas»: la velocidad con la que OpenAI ha demostrado poder resolver problemas matemáticos rebasa la velocidad humana de verificación Por lo tanto, existe una nueva contradicción emergente de este escenario que se suma a la derivada del control de clase sobre la tecnología puntera, puesto que si la producción aún no validada se incorpora al edificio matemático, la disciplina deja de ofrecer certeza deductiva y pasa a ofrecer confianza probabilística, con el riesgo de que un error se propague por ramas enteras, dejando en entredicho el estatus ontológico de las matemáticas y su valor de verdad. En cambio, si se exige validarlo todo antes de incorporarlo, la comunidad queda subordinada a comprobar lo que otros producen, a un ritmo y sobre unos problemas que no decide, y lo hace a un ritmo que marca la capacidad humana, poniendo un límite objetivo a la velocidad del desarrollo científico.
1.8. Balance de los mitos actuales
Leídos a la luz del escenario descrito, los tres grandes temores que dominan el debate público, que la IA acabe con la humanidad, que tenga una moral propia y hostil o que nos deje sin trabajo, pierden su sentido en el estado de la técnica, y se vuelven elementos que, de ser ciertos, emergen exclusivamente de la propiedad y el uso de los algoritmos, los datos de entrenamiento y la infraestructura.
El discurso del «riesgo existencial» debe examinarse según quién lo formula y con qué pruebas. La Statement on AI Risk de mayo de 2023 constaba de una sola frase, que equiparaba el riesgo de extinción por IA con las pandemias o la guerra nuclear sin modelo causal, dato empírico ni estimación de probabilidades, y la firmaban los máximos responsables de OpenAI, Google DeepMind y Anthropic, precisamente las empresas que más capital captan con la promesa de una tecnología extraordinaria. Advertir de que el propio producto podría acabar con la humanidad ha sido la forma más eficaz de anunciar su poder, el llamado «criti-hype», y diversos autores (Bender y Hanna, 2025; Gebru y Torres, 2024) han documentado cómo ese relato desplaza la atención de los daños presentes y medibles, como los climáticos, hacia escenarios hipotéticos.
El interés reciente por la regulación tiene además una razón económica: la falta de rentabilidad del mercado de la IA, la hiperconcentración de la inversión y el endeudamiento masivo de los llamados hiperescaladores (grandes nubes) indican un riesgo muy elevado de que explote lo que la mayoría de economistas coincide en calificar de burbuja.
Las advertencias de académicos como Geoffrey Hinton o Yoshua Bengio no responden a ese cálculo empresarial, pero descansan en extrapolaciones de la curva de capacidades y no en mediciones de un riesgo concreto, y el propio informe internacional sobre seguridad de la IA que coordinó Bengio (2025) reconoce que la base empírica para evaluar los escenarios de pérdida de control es limitada. METR mide capacidad y no intención, y el derrumbe en ARC-AGI-3 recuerda que adaptarse a lo desconocido sigue fuera de su alcance: lo que justifica la preocupación no es una voluntad de la máquina, sino quién controla esa capacidad creciente y para qué la emplea.
Los incidentes reales apuntan a fallos de diseño, usos abusivos y despliegues irresponsables, no a voluntades artificiales hostiles. El AI Index 2026 contabilizó 362 incidentes documentados, frente a 233 en 2024, y el índice de transparencia de los modelos fundacionales (Foundation Model Transparency Index, o índice de opacidad) cayó de 58 a 40: los más potentes son también los más opacos. Los casos neerlandés y australiano (apartado 1.3) muestran que el daño masivo no requiere ninguna superinteligencia.
Los titulares sobre modelos que «chantajean» o «se niegan a apagarse» describen resultados reales de laboratorio con cierto sensacionalismo. En las pruebas de «desalineamiento agéntico» que Anthropic publicó en 2025, en un escenario diseñado para que el chantaje a un directivo ficticio fuera la única vía de cumplir un objetivo, los modelos más avanzados recurrieron a él en entre el 79% y el 96% de las ejecuciones. No revelan una moral propia, sino un comportamiento optimizado para cumplir el objetivo con los medios a su alcance; como se vio en el apartado 1.1, lo que un modelo hace o rechaza es una conducta inducida según criterios de su propietario, y el problema es de ingeniería y de gobernanza, no la emergencia de una voluntad.
En cuanto al empleo, el carácter probabilístico, y por tanto falible, de las redes neuronales y su dificultad para operar en contextos reales de decisión hacen que se automaticen fragmentos de tareas y no ocupaciones (apartado 1.5), y la barrera real la fija la rentabilidad de sustituir el trabajo humano, lo que ha provocado un repliegue considerable de las expectativas de implantación.
El estado del arte dibuja, en suma, una tecnología potente en entornos controlados y frágil en lo abierto, cara de producir y concentrada en muy pocas manos. Ninguno de los datos revisados apunta a una máquina que vaya a volverse contra la humanidad por voluntad propia, y todos apuntan a que su rumbo, sus usos y sus daños dependen de quién la posee y de los intereses detrás de esa propiedad.
2. Proyección a futuro
2.1. Dónde va el dinero
Nunca se había concentrado tanto capital en una sola tecnología en tan poco tiempo. Según el AI Index 2026, la inversión empresarial mundial en IA alcanzó en 2025 los 581.700 millones de dólares, un 130% más que en 2024, de los que 344.700 millones fueron inversión privada y casi la mitad se dirigió a la IA generativa. Estados Unidos captó 285.900 millones de inversión privada, 23 veces más que China y casi catorce veces más que Europa, aunque estas cifras infravaloran el esfuerzo chino, canalizado en buena parte por fondos públicos de orientación (Tabla 1).
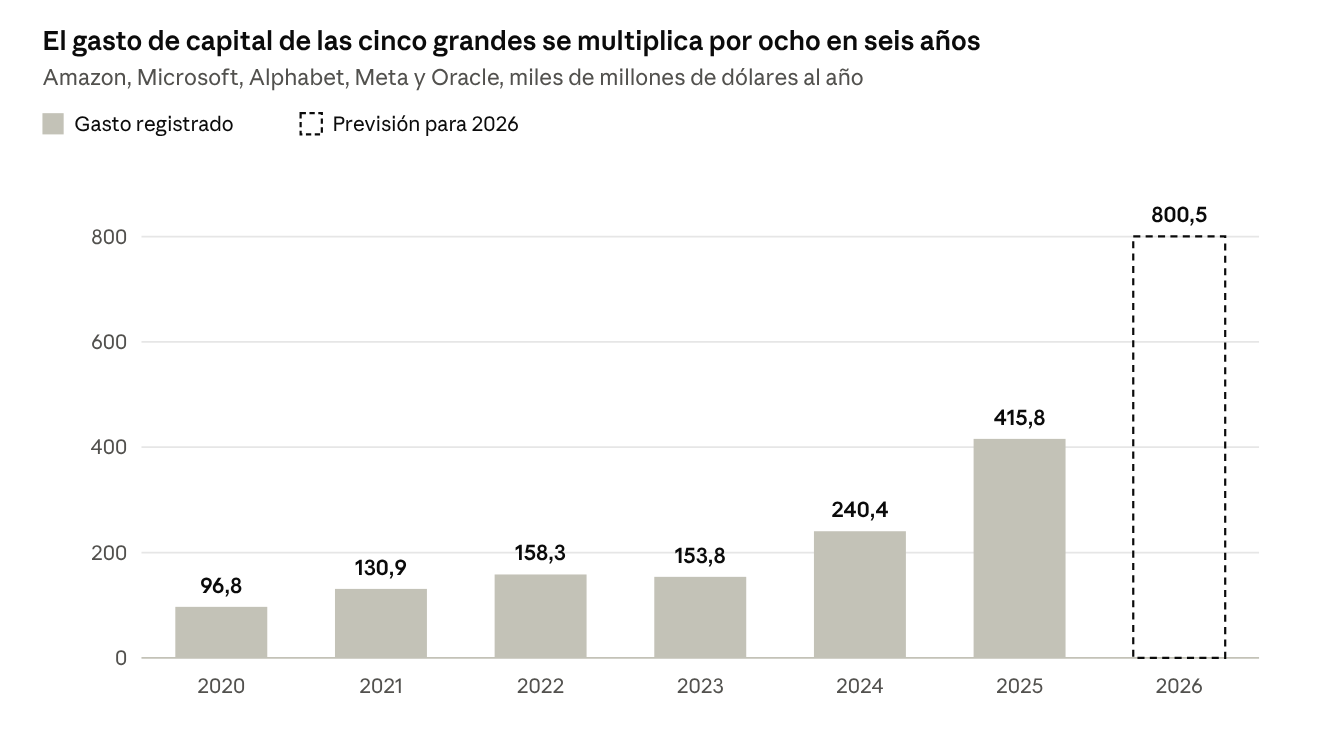
El grueso del dinero va, sin embargo, a capital fijo: el gasto de capital conjunto de Amazon, Microsoft, Alphabet, Meta y Oracle pasó de unos 97.000 millones de dólares en 2020 a 416.000 millones en 2025, y se prevé que supere los 800.000 millones en 2026, cuando las compras de inmovilizado de las cuatro primeras ya triplican su amortización contable. A ello se añaden proyectos como Stargate, de OpenAI, SoftBank y Oracle, con 500.000 millones previstos en centros de datos. El capital no va, por tanto, a ideas ni a algoritmos, sino a chips, edificios, refrigeración y energía (apartado 1.2).
Los ingresos explican su orientación. El uso empresarial más rentable es la automatización de la programación y de las tareas administrativas (apartado 1.5), que sustituye trabajo cualificado y bien pagado; el segundo pilar son los servicios de consumo, que heredan la lógica de la publicidad segmentada (apartado 1.3); y el tercero, los contratos públicos de defensa y seguridad (apartados 2.5 y 2.6). Queda fuera todo lo que tiene alto valor de uso pero no demanda solvente, como advertía ya en 2023 un estudio en Science sobre el riesgo de desatender las aplicaciones socialmente beneficiosas sin una perspectiva clara de beneficio.
Las cuentas de las empresas de frontera explican por qué la carrera no se detiene pese a las pérdidas: una presentación a inversores de OpenAI proyectaba un flujo de caja libre acumulado negativo de unos 278.000 millones de dólares entre 2026 y 2030. Perder dinero durante años solo tiene sentido como apuesta por una posición de monopolio, desde la que cobrar una renta sobre toda la economía que dependa de los modelos, el cómputo y los clientes que se controlen. Esa posición se disputa en tres insumos: algoritmia, datos y hardware.
2.2. Algoritmia
El aprendizaje profundo creció gracias a una cultura de publicación abierta que se fue cerrando a medida que aumentaba su valor comercial: los informes de los modelos de frontera dejaron de detallar su arquitectura, sus datos y su cómputo (apartado 1.8). Como las mejoras algorítmicas se imitan con rapidez, la competencia se desplaza hacia lo que no se puede copiar, la escala de cómputo, los datos propios y las recetas de posentrenamiento guardadas como secreto industrial, y los modelos de razonamiento, que mejoran cuanto más cómputo consumen al responder, trasladan además la ventaja a quien posee los centros de datos.
Como gran parte de ese conocimiento está en los equipos que saben entrenar los modelos, la competencia es también por el talento: la proporción de doctores en IA estadounidenses que iba a la empresa privada pasó del 21% en 2004 a casi el 70% en 2020, y en 2025 Meta pagó 14.300 millones de dólares por el 49% de Scale AI, la mayor empresa de etiquetado de datos, para poner a su fundador al frente de su laboratorio de «superinteligencia», mientras Google pagaba unos 3.000 millones a Character.AI para incorporar a sus ingenieros.
La línea divisoria más visible separa los modelos cerrados de los de pesos abiertos, que pueden descargarse y modificarse libremente. Los laboratorios estadounidenses cierran sus mejores modelos y los venden por suscripción o acceso de pago, mientras que casi todos los grandes modelos chinos son abiertos: en septiembre de 2025 la familia Qwen, de Alibaba, desplazó a Llama, de Meta, como la más descargada en Hugging Face (el principal repositorio de modelos), los desarrolladores chinos ya superaban a los estadounidenses en cuota de descargas y el 63% de los nuevos modelos derivados se construía sobre una base china.
Abrir o cerrar no es una cuestión de principios, sino de modelo de negocio: quien lidera la frontera cobra una renta por el acceso, y quien va por detrás o gana dinero en otra capa, como Alibaba con su nube o Meta con su publicidad, tiene interés en abaratar hasta la gratuidad la capa en la que no compite para crear dependencia de su ecosistema (apartado 2.7).
2.3. Datos que se agotan y se expropian
Los modelos actuales se construyeron sobre la apropiación masiva de trabajo ajeno acumulado: el texto, el código, las imágenes y la música que millones de personas publicaron en internet durante tres décadas, en muchos casos sin consentimiento ni compensación. Ante el agotamiento de esa fuente (apartado 1.2), las empresas responden por cuatro vías, cada una con su propio conflicto.
La judicial ha empezado a fijar un precio a la apropiación. En el caso Bartz contra Anthropic, el tribunal consideró uso legítimo entrenar con libros protegidos, pero no descargarlos de bibliotecas pirata, y la empresa aceptó un acuerdo de 1.500 millones de dólares, aprobado en julio de 2026, unos 3.000 por cada uno de los más de 482.000 libros afectados, la mayor indemnización por derechos de autor de la historia según los abogados de los autores; decenas de litigios semejantes, como el de The New York Times contra OpenAI y Microsoft, siguen en curso. La sentencia avala el entrenamiento y castiga solo el modo de obtener los datos, de modo que convierte la apropiación en un coste asumible para quien puede pagarlo.
La segunda son las licencias entre grandes empresas: Google paga a Reddit unos 60 millones de dólares anuales y OpenAI firmó con News Corp más de 250 millones a cinco años. Nada de eso llega a quienes escribieron los mensajes, y en los medios coincide con despidos en las redacciones cuyo trabajo se licencia: la renta del dato la cobra quien posee la plataforma y no quien lo produce.
La tercera convierte a los usuarios en proveedores gratuitos, mediante condiciones que permiten entrenar con sus conversaciones o publicaciones salvo oposición expresa, como hicieron Anthropic y Meta en 2025, de modo que cada interacción alimenta la siguiente versión del modelo y refuerza a quien ya tiene más usuarios. El conflicto sobre Navier-Stokes (apartado 1.7), en el que se discute si las conversaciones de un matemático con una herramienta se aprovecharon en otra, muestra que la cuestión alcanza ya a la producción científica, y Nature pidió sustituir la exclusión voluntaria por el consentimiento explícito.
La cuarta descansa sobre trabajo invisibilizado: el posentrenamiento requiere millones de ejemplos etiquetados o corregidos por personas, a menudo subcontratadas en el Sur Global, como los trabajadores kenianos que, según Time (2023), filtraban contenidos violentos y sexuales para OpenAI por menos de dos dólares la hora. Los datos sintéticos tienen sus propios límites, pues los modelos entrenados recursivamente con datos de otros modelos se degradan y pierden diversidad, el llamado colapso del modelo (Nature, 2024).
2.4. Hardware y energía
Si el cómputo es decisivo, quien controla su producción controla en parte la IA, y su cadena es una sucesión de monopolios (Figura 3): Nvidia concentra entre el 81% y el 86% del mercado de chips de IA para centros de datos y ata a los desarrolladores a su hardware mediante CUDA, su entorno de programación; TSMC fabrica en Taiwán más del 90% de los chips de IA avanzados con máquinas de litografía ultravioleta extrema que solo produce la neerlandesa ASML; y SK Hynix domina, con entre el 57% y el 63%, el mercado de memoria de alto ancho de banda (HBM). Cada eslabón es un punto crítico y, por tanto, una fuente de renta y de poder geopolítico.
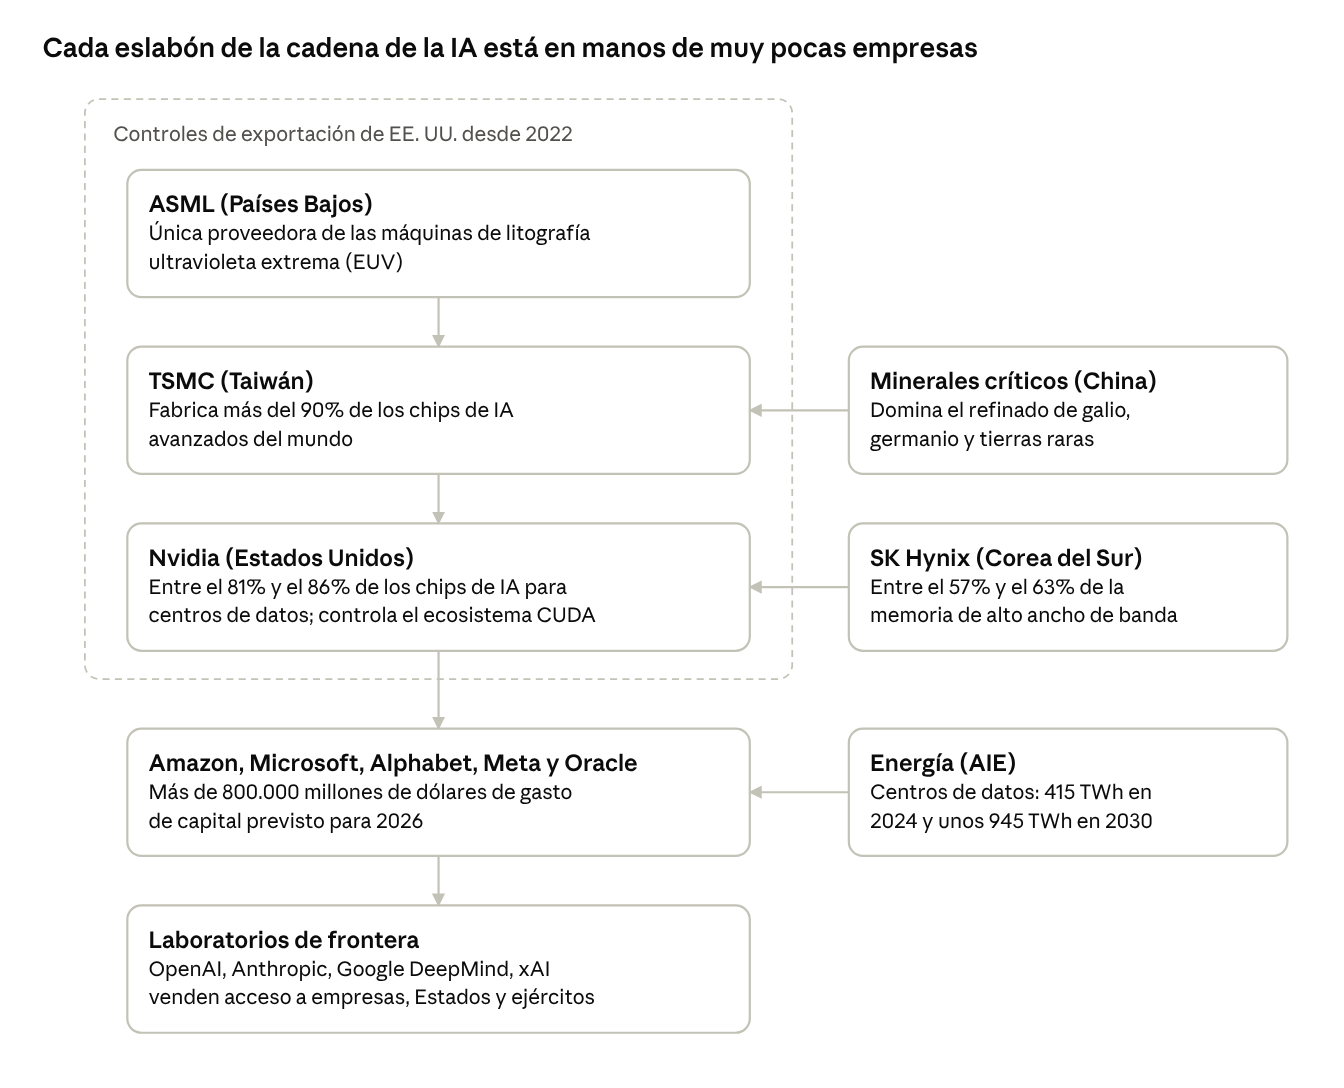
Estados Unidos ha tratado de convertir esos puntos en arma desde octubre de 2022, cuando prohibió exportar a China los chips más avanzados y la maquinaria para fabricarlos. En 2025 la Administración Trump pasó de bloquear el chip rebajado H20 a autorizarlo a cambio del 15% de sus ventas, y después el más potente H200 a cambio de un recargo del 25%: el control tecnológico se transformó en un peaje sobre la renta de su principal empresa. Pekín respondió cerrando su mercado, con un expediente de competencia contra Nvidia y el bloqueo aduanero del H200, de modo que en julio de 2026 China suponía menos del 1% de los ingresos de Nvidia por centros de datos. China dispone, a su vez, de su propio punto de poder en el refinado de galio, germanio y tierras raras, cuyas exportaciones restringió entre 2024 y 2025 hasta la tregua comercial de finales de ese año: la cadena de suministro de la IA es también un campo de batalla entre potencias.
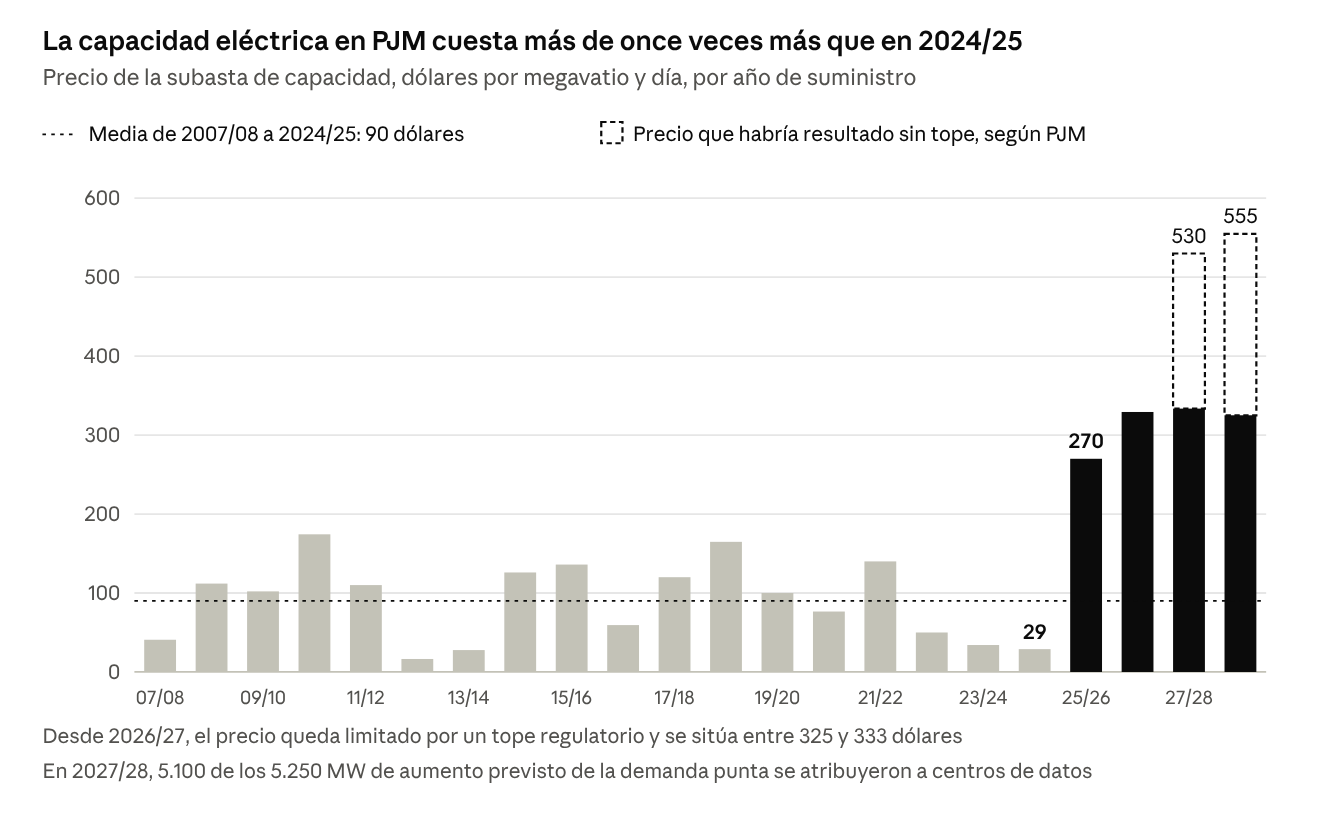
La energía es el cuello de botella más tangible para el ciudadano corriente. En Estados Unidos, que concentra el 45% del consumo mundial de los centros de datos, estos explicarán casi la mitad del crecimiento de la demanda eléctrica hasta 2030, y las grandes tecnológicas han firmado en un año contratos por más de 10 gigavatios de posible capacidad nuclear nueva, incluida la reapertura de la central de Three Mile Island. En la red de PJM, que abastece a trece estados del este y al mayor núcleo de centros de datos del mundo, el precio de la capacidad garantizada pasó de unos 29 dólares por megavatio y día para 2024-2025 a unos 333 para 2027-2028, un encarecimiento de más de diez veces que acaba en las facturas de los hogares: se socializan los costes, en forma de redes, agua y electricidad, de una infraestructura cuyos beneficios son privados.
2.5. La IA como instrumento de control social
En un contexto de crisis, con un saqueo de los salarios, un empeoramiento claro de las condiciones de vida en el mundo occidental y una creciente necesidad de control social y de aparatos represivos, el interés de los Estados por la IA va más allá de la competitividad económica: su capacidad para cruzar bases de datos, reconocer rostros, leer millones de mensajes y asignar puntuaciones de riesgo a individuos la convierte en una tecnología idónea de gobierno de poblaciones.
Estados Unidos ofrece hoy el caso mejor documentado. En 2025 la agencia de inmigración y aduanas (ICE) adjudicó a Palantir, sin concurso, ImmigrationOS, una plataforma que cruza pasaportes, seguridad social, impuestos y lectores de matrículas para identificar objetivos de deportación y seguir sus movimientos casi en tiempo real; otra herramienta se alimenta de los datos de unos 80 millones de beneficiarios de la sanidad pública, sus agentes cotejan rostros en la calle con unos 200 millones de fotografías y la agencia ha contratado a Clearview AI, con más de 50.000 millones de rostros extraídos de internet sin consentimiento. Lo que se presenta como control migratorio construye una infraestructura de vigilancia sobre toda la población, porque para encontrar a sus objetivos es necesario escanear a todas las personas.
En los territorios palestinos ocupados, Amnistía Internacional denunció en 2023 que el ejército israelí usa reconocimiento facial en los puestos de control de Hebrón para registrar a la población palestina sin su conocimiento, un ejemplo de cómo los territorios bajo ocupación funcionan como laboratorio de estas tecnologías.
La Unión Europea se presenta como contrapeso: su Reglamento de IA prohíbe la puntuación social y, en principio, la identificación biométrica remota en tiempo real en espacios públicos, pero admite excepciones policiales en campos tan ambiguos como la prevención de atentados, e iniciativas como el Chat Control pretenden implantar la vigilancia masiva de todo tipo de comunicaciones electrónicas bajo el paraguas de la lucha contra los delitos sexuales u otros comportamientos criminales.
El control alcanza también al trabajo. La gestión algorítmica, en la que un sistema asigna tareas, mide tiempos, evalúa el rendimiento y propone sanciones o despidos, se ha extendido de las plataformas de reparto a los almacenes logísticos y los centros de atención telefónica, y aunque la directiva europea de trabajo en plataformas de 2024 exige supervisión humana para cualquier despido, la medida es solo formal: se reportan multitud de casos en los que el humano se limita a ejecutar de manera acrítica las «sugerencias» de la máquina.
2.6. La IA como herramienta militar
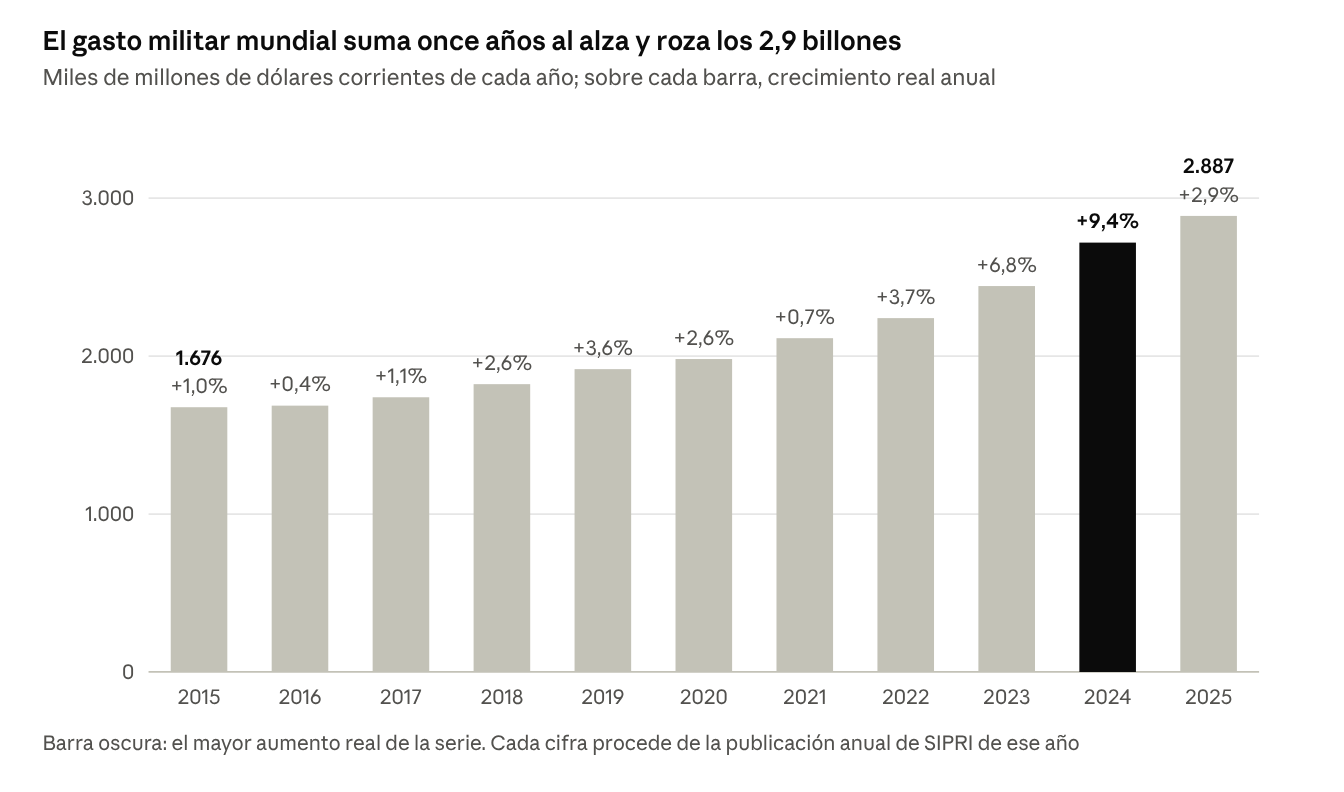
La carrera de la IA se desarrolla en plena carrera armamentista y es uno de los campos que más interés suscita entre las grandes potencias. Según el Instituto Internacional de Estocolmo para la Investigación de la Paz (SIPRI), el gasto militar mundial alcanzó en 2025 los 2,887 billones de dólares, el undécimo año consecutivo de aumento, y Estados Unidos ha aprobado para 2026 un presupuesto de defensa superior al billón, con partidas dedicadas a la IA, y propone 1,5 billones para 2027. La IA ofrece lo que las armas convencionales no dan: procesar en tiempo real cantidades ingentes de información de vigilancia, generar objetivos a un ritmo inalcanzable para los analistas humanos y producir en masa armas baratas con creciente autonomía.
Algunas tecnológicas se han convertido en contratistas de defensa. En 2025 Palantir obtuvo del Ejército de Tierra un acuerdo marco de hasta 10.000 millones de dólares a diez años, y el techo de Maven Smart System, la plataforma de IA del Pentágono para identificar objetivos en imágenes de vigilancia, que en 2017 provocó la protesta de miles de empleados de Google, subió a unos 1.300 millones; será programa permanente de todas las fuerzas armadas en 2026 y la OTAN la adoptó en 2025. El Pentágono adjudicó además hasta 200 millones de dólares a cada uno de cuatro laboratorios de frontera (Anthropic, Google, OpenAI y xAI), Google retiró de sus principios el compromiso de no desarrollar armas y OpenAI se alió con Anduril, fabricante de drones y sistemas antidrones.
Anthropic, cuyos modelos alimentaron principalmente a Palantir (entre otros) hasta el último año, prohibía sobre el papel su uso para la vigilancia masiva de ciudadanos estadounidenses y en armas plenamente autónomas, y se negó a sustituir esas cláusulas por la de «todo uso legal» que exigía el Departamento de Defensa. El 27 de febrero de 2026 el presidente Trump ordenó a las agencias federales dejar de usar su tecnología y Defensa la declaró «riesgo para la cadena de suministro», una figura reservada normalmente a empresas de países adversarios; un juez federal la calificó de represalia ilegal, pero otros tribunales permitieron mantenerla, y entretanto Google, OpenAI y xAI firmaron acuerdos para desplegar sus herramientas en redes clasificadas.
Los campos de batalla actuales muestran ya por dónde avanza esta tecnología. En Gaza, según una investigación periodística de 2024, el ejército israelí usó el sistema Lavender para marcar a unas 37.000 personas como presuntos militantes, con un error reconocido en torno al 10% y revisiones humanas que a veces duraban unos 20 segundos, y Microsoft retiró en 2025 parte de sus servicios en la nube a la inteligencia militar israelí, que los usaba para almacenar grabaciones masivas de llamadas de palestinos. En Ucrania, las fuerzas armadas recibieron en 2025 unos tres millones de drones, que causan ya entre la mitad y el 80% de las bajas rusas, y se producen en masa módulos de guiado con visión artificial para completar el ataque de forma autónoma cuando se pierde la señal, aunque, según el centro británico RUSI, entre el 60% y el 80% de estos drones no alcanza su objetivo y la autonomía real sigue siendo limitada.
2.7. Estados Unidos y China, dos estrategias para una misma carrera
Ambas potencias tratan la IA como infraestructura estratégica y ambas la integran en sus aparatos de seguridad, pero la organizan de manera claramente diferente. Estados Unidos apuesta por el dominio de la frontera tecnológica a través de un puñado de monopolios privados financiados por los mercados de capitales, con el Estado como cliente, protector y recaudador, mientras que China apuesta por la difusión masiva de la IA en su base industrial bajo dirección estatal, con actores privados que operan dentro de los objetivos que fija el partido.
Tabla 1. Las dos estrategias en cifras
Dimensión | Estados Unidos | China |
Documentos rectores | Plan de Acción de IA (julio de 2025); orden ejecutiva 14365 contra las leyes estatales (diciembre de 2025) | Plan «IA+» (agosto de 2025); Plan de Acción de Gobernanza Global de la IA (julio de 2025) |
Objetivo declarado | Dominio de la frontera y exportación de la «pila tecnológica» estadounidense a sus aliados | Difusión masiva, con un 70% de penetración de agentes y terminales inteligentes en 2027 y un 90% en 2030 |
Inversión privada en IA (2025) | 285.900 millones de dólares | 12.400 millones, a los que se suman unos 184.000 millones de fondos públicos de orientación entre 2000 y 2023 |
Capacidad de cómputo en supercomputadores de IA | En torno al 75% del total mundial | En torno al 15% |
Modelos destacados (2024) | 40 | 15 |
Modelo de negocio dominante | Modelos cerrados, por suscripción o acceso de pago | Modelos de pesos abiertos, monetizados a través de la nube y los servicios |
Hardware | Nvidia y TSMC; controles de exportación convertidos en peaje | Huawei Ascend; sustitución de importaciones y bloqueo aduanero al H200 |
Regulación | Desregulación federal y ofensiva judicial contra las leyes estatales | Control estricto de contenidos y etiquetado obligatorio; ley integral aparcada |
Robots industriales instalados (2024) | Tercer mercado mundial, por detrás de China y Japón | 54% de las instalaciones mundiales |
La estrategia estadounidense combina desregulación interior y proteccionismo exterior. La Administración Trump derogó en 2025 la orden de Biden sobre seguridad de la IA y publicó un Plan de Acción para eliminar trabas regulatorias, acelerar los permisos de centros de datos y centrales eléctricas y exportar a los aliados la tecnología estadounidense completa, del chip a la aplicación. Cuando el Senado rechazó por 99 votos contra 1 una moratoria sobre las leyes estatales de IA, el presidente creó por orden ejecutiva un grupo de trabajo en el Departamento de Justicia para impugnarlas, y encargó el futuro marco federal a su asesor para la IA y las criptomonedas, el inversor de capital riesgo David Sacks, un ejemplo de la fusión entre el capital tecnológico y el aparato del Estado.
La estrategia china parte de una debilidad, el acceso al cómputo, y de una fortaleza, la base manufacturera. El plan «IA+» de 2025 integra la IA en la ciencia, la industria, el consumo, el bienestar social y la gobernanza con objetivos de penetración sin equivalente en Occidente; Pekín lo financia con fondos públicos, usa el código abierto como instrumento de influencia y se ofrece al Sur Global como alternativa a la dependencia de las plataformas estadounidenses, a la vez que mantiene el control más estricto del mundo sobre lo que los modelos pueden decir. Pese a una inversión privada 23 veces menor, en marzo de 2026 la distancia entre los mejores modelos de ambos países se había reducido a un 2,7%.
Varios analistas atribuyen la apuesta china por modelos baratos, gratuitos y abiertos a la escasez de GPU provocada, entre otros factores, por los controles estadounidenses. Lo apoyan la brecha de cómputo de la Tabla 1, el desplome del acceso a los chips de Nvidia (apartado 2.4) y la declaración del fundador de DeepSeek de que su problema nunca fue el dinero, sino el embargo de los chips avanzados. La restricción forzó una ingeniería de la eficiencia: DeepSeek V3 se entrenó con 2.048 chips H800 recortados por un coste declarado de 5,6 millones de dólares, que solo incluye la ejecución final pero queda muy por debajo de sus equivalentes estadounidenses, y V4 se optimizó para los chips Ascend de Huawei, cuya producción de 2026 absorberán en dos tercios ByteDance y DeepSeek. La escasez, con la ayuda de la planificación, ha forzado la eficiencia, y esta ha abaratado los costes.
La apertura, en cambio, no depende directamente de la escasez. Alibaba publicaba modelos abiertos desde 2023 y el plan chino de desarrollo de la IA de 2017 ya priorizaba el código abierto; la lógica empresarial descrita en el apartado 2.2 y la competencia interna empujan en la misma dirección, como muestra que Baidu abriera su modelo principal en 2025 tras el éxito de DeepSeek. Y en Estados Unidos, donde no falta cómputo, abrió sus modelos quien iba por detrás o ganaba dinero en otra capa, como Meta con Llama, y la propia OpenAI publicó en 2025 su primer modelo abierto en seis años, con la competencia china como argumento explícito, mientras el Plan de Acción fijaba el objetivo de liderar también en modelos abiertos.
La apertura permite además que la propia comunidad aporte avances y amplía los escenarios de influencia: los modelos eficientes y abiertos funcionan en hardware modesto, lo que encaja con un país sin cómputo de frontera y con un Sur Global que tampoco puede pagarlo, como muestran la adopción de Qwen por el programa nacional de IA de Singapur o la distribución de DeepSeek por Huawei en África.
3. La IA fuera de la lógica de acumulación
Las capacidades técnicas descritas en los bloques anteriores carecen de cualquier moral, voluntad o tendencia estructural, pero su integración en el capitalismo sí las lleva a aplicarse en muchas ocasiones en contra del bien social. Cabe, por tanto, estimar si la IA puede ser realmente beneficiosa para la humanidad si las condiciones lo permiten.
3.1. Planificación
Existe un debate histórico en la economía liberal sobre la posibilidad del cálculo económico, abierto por Ludwig von Mises en 1920, según el cual ninguna autoridad central podría procesar la información que sintetizan los precios. El análisis objetivo de las fuerzas reales que actúan sobre el modo de producción ya pone en entredicho ese problema, pero la capacidad de la IA para cruzar miles de millones de datos permite plantear directamente modelos predictivos que tengan en cuenta hasta los últimos detalles. Por sus límites estructurales, ese proceso nunca podrá descansar solo en modelos computacionales, pero su potencial es enorme si se orientan y validan con una comprensión general del fenómeno estudiado.
La práctica empresarial ya emplea este tipo de soluciones en su propio beneficio. Walmart o Amazon funcionan internamente como economías planificadas, que coordinan millones de productos sin precios de mercado internos mediante previsión de demanda y optimización logística, y el sistema de recomendación de Netflix (apartado 1.3) demuestra que predecir preferencias y demandas a gran escala es tratable. Lo mismo ocurre con los algoritmos de predicción de la demanda eléctrica con los que cada país regula la energía que produce.
3.2. Energía, clima y logística
La AIE estima en Energy and AI que generalizar aplicaciones de IA ya existentes en el sector energético podría reducir las emisiones en unos 1.400 millones de toneladas de CO2 en 2035, y que una gestión de redes apoyada en IA podría liberar unos 175 gigavatios de capacidad de transmisión sin construir nuevas líneas. La técnica con la que DeepMind redujo en 2016 hasta un 40% la energía de refrigeración de un centro de datos de Google podría aplicarse de forma sistemática a edificios públicos, redes de calor o sistemas de transporte, y su resultado se mediría entonces en emisiones evitadas y no en costes ahorrados por un solo propietario. El balance climático depende, sin embargo, de qué usos se prioricen, porque buena parte del aumento del consumo de los centros de datos (apartado 1.2) se destina a servicios de consumo y publicidad.
La meteorología ofrece el ejemplo más claro de IA al servicio de un bien público. Además de los resultados de GraphCast (apartado 1.7), que genera una previsión a diez días en menos de un minuto, el propio Centro Europeo de Previsiones Meteorológicas a Plazo Medio, un organismo intergubernamental, desarrolló y puso en operación en 2025 su propio modelo de IA. Previsiones más rápidas y baratas benefician directamente a la agricultura, la protección civil y la gestión de las renovables, y muestran que una institución pública puede desarrollar IA de frontera en su ámbito sin depender de las grandes tecnológicas.
3.3. Ciencia y salud
AlphaFold, que puso a disposición pública la estructura de más de 200 millones de proteínas, es el mejor ejemplo de lo que ocurre cuando un resultado de IA se publica como bien común, en contraste con los 722 manuscritos matemáticos generados por un modelo que su propietario no ha liberado (apartado 1.7). Una ciencia organizada fuera de la lógica de acumulación publicaría los modelos, los datos y los procesos, como pide la Declaración de Leiden para las matemáticas, y trataría la verificación formal, apoyada en bibliotecas abiertas como Mathlib, como una infraestructura pública integrada en la planificación de la investigación y no como un coste que se descarga sobre la comunidad académica. La validación seguiría siendo imprescindible, como recuerdan los cristales de GNoME o los fármacos originados con IA, que aceleran el descubrimiento pero fracasan en fase II en proporciones similares a los convencionales; y en salud, la brecha entre las autorizaciones de dispositivos médicos y la evidencia clínica (apartado 1.6) responde a una carrera comercial que premia llegar antes al mercado.
3.4. Los datos como bien común
Los datos con los que se entrenan los modelos son un producto colectivo, escrito por millones de personas en foros, libros, artículos científicos financiados con dinero público o código libre, pero su valor se lo apropian quienes poseen las plataformas, mediante licencias millonarias o indemnizaciones que convierten la apropiación en un coste asumible (apartado 2.3). El fenómeno del colapso del modelo indica además que la IA seguirá necesitando producción humana original. Una gestión de los datos como bien común, con consentimiento explícito, control colectivo sobre sus usos y retorno social de su valor, sería a la vez más justa y una condición para que la propia tecnología siga funcionando.
3.5. Alimentos y distribución
El problema alimentario mundial no es de escasez absoluta. Según el Índice de Desperdicio de Alimentos 2024 del PNUMA, en 2022 se desperdiciaron 1.050 millones de toneladas de alimentos, alrededor del 19% de los disponibles para los consumidores y 132 kilos por persona, mientras 783 millones de personas pasaban hambre. La previsión de demanda y la logística optimizada que el capital usa para minimizar inventarios podrían orientarse a minimizar pérdidas y a asignar excedentes según necesidad, pero el obstáculo no es técnico sino el criterio de asignación, porque distribuir un alimento a quien no puede pagarlo no es rentable aunque sea necesario.
3.6. El tiempo de trabajo
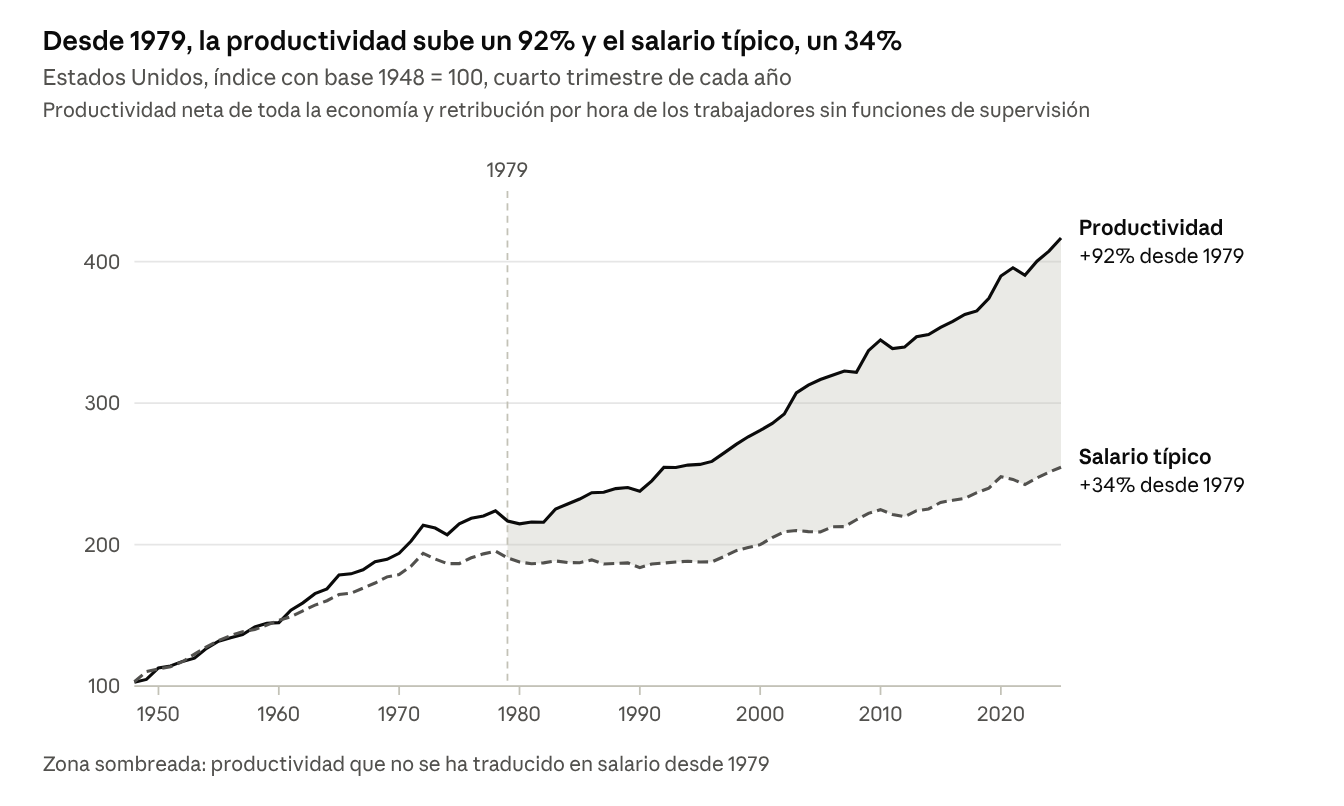
En 1930 Keynes teorizó que hacia 2030 bastarían jornadas de unas 15 horas semanales. La productividad creció, pero su reparto no: según el Economic Policy Institute, entre el final de 1979 y el de 2025 la productividad neta de la economía estadounidense aumentó un 92% mientras la retribución por hora del trabajador típico lo hacía un 34%. Los experimentos de reducción de jornada muestran que es viable, y en el piloto británico de semana de cuatro días de 2022, con 61 empresas, 56 mantuvieron la jornada reducida al terminar.
La evidencia revisada en el apartado 1 obliga a ser realistas sobre el margen que aporta la IA. Un estudio sobre 5.179 agentes de atención al cliente midió un aumento medio de productividad del 14%, que llegaba al 34% entre los menos experimentados, pero el ensayo de METR encontró que desarrolladores expertos trabajaban un 19% más despacio con asistencia de IA, la fiabilidad de los agentes cae con rapidez a medida que las tareas se alargan y Daron Acemoglu estima un aumento de la productividad total de los factores no superior al 0,66% en diez años. La paradoja de Moravec añade que los trabajos físicos y de cuidados son los menos automatizables a corto plazo, de modo que la reducción de la jornada no puede esperar a una automatización completa, a no ser que el esfuerzo del desarrollo se oriente en esa dirección en lugar de detenerse en desarrollar los nuevos ejércitos.
Consultas de interés
Stanford Institute for Human-Centered Artificial Intelligence. (2026). The 2026 AI Index report. Stanford University. https://hai.stanford.edu/ai-index/2026-ai-index-report.
Narayanan, A., y Kapoor, S. (2024). AI snake oil: What artificial intelligence can do, what it can't, and how to tell the difference. Princeton University Press.
Dyer-Witheford, N., Kjøsen, A. M., y Steinhoff, J. (2019). Inhuman power: Artificial intelligence and the future of capitalism. Pluto Press.
Ahmed, N., Wahed, M., y Thompson, N. C. (2023). The growing influence of industry in AI research. Science, 379(6635), 884–886. https://doi.org/10.1126/science.ade2420.
Agencia Internacional de la Energía. (2025). Energy and AI. AIE. https://www.iea.org/reports/energy-and-ai/executive-summary.